공간생물학의 다음 병목은 생물학이 아니라 ‘메모리’일 수 있다.
공간전사체 데이터가 저장된 파일의 크기를 확인하고 충분한 디스크를 준비한다. 분석을 시작하자 작업은 예상보다 오래 걸리고, 어느 순간 메모리 부족으로 중단된다. GPU를 추가해도 속도는 크게 개선되지 않는다.
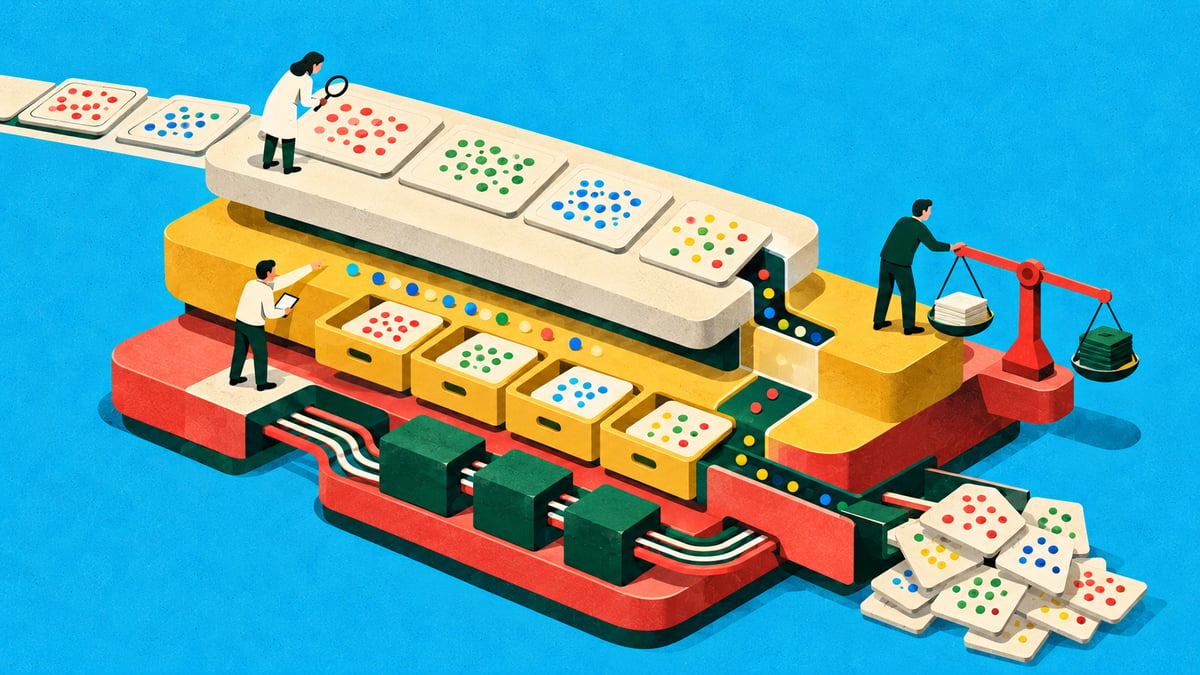
이런 상황이 반복되는 이유는 공간전사체의 데이터 문제가 단순한 저장 용량의 문제가 아니기 때문이다. 실제 성능은 RAM과 VRAM, 저장장치의 입출력 속도, CPU 전처리, 네트워크를 통한 데이터 이동 및 분석 과정에서 생성되는 중간 데이터가 함께 결정한다.
파일의 크기는 눈에 보인다. 그러나 분석이 실행되는 동안 필요한 peak memory, 즉 최대 메모리 사용량은 잘 보이지 않는다.
해상도가 높아질수록 행렬은 더 빠르게 커진다
공간전사체 데이터는 일반적으로 위치 또는 세포와 유전자의 관계를 거대한 행렬로 표현한다. 측정 해상도가 높아지고 검출되는 transcript가 늘어나면 행과 열뿐 아니라 실제 값이 존재하는 항목, 즉 non-zero entry도 급증한다.
원본 데이터는 sparse matrix, 즉 대부분의 값이 비어 있는 희소 행렬 형태로 압축할 수 있다. 하지만 filtering, normalization, 통합 및 세포별 연산 과정에서 데이터가 복사되거나 새로운 중간 결과가 생성된다. 특정 연산이 희소 구조를 충분히 활용하지 못하면 저장된 파일보다 몇 배 큰 메모리가 필요할 수도 있다.
따라서 “몇 테라바이트를 저장할 수 있는가”보다 “분석의 어느 단계에서 데이터가 어떻게 확장되는가”가 더 중요한 질문이다.
GPU가 모든 병목을 해결하지는 않는다
공간전사체 분석은 GPU에 적합한 연산도 많지만, 모든 단계가 GPU 중심인 것은 아니다. 대규모 파일을 읽고 정리하는 작업, metadata를 결합하는 과정, 희소행렬 filtering과 형식 변환은 CPU와 메모리 대역폭, I/O 성능에 크게 의존할 수 있다.
GPU 연산 자체는 빠르더라도 데이터를 저장장치에서 RAM으로, 다시 GPU의 VRAM으로 옮기는 시간이 길다면 전체 분석은 빨라지지 않는다. 비싼 가속기를 추가했지만 가속기가 데이터를 기다리는 상황이 생기는 것이다.
상식적으로는 컴퓨팅 자원을 더 구매하면 문제가 해결될 것처럼 보인다. 그러나 실제로는 계산보다 데이터 이동이 느리거나, 한 단계의 peak memory 때문에 전체 시스템 사양을 과도하게 높여야 하는 경우가 있다. 공간전사체 인프라는 CPU와 GPU 중 하나를 선택하는 문제가 아니라 연산과 메모리, 저장장치의 균형을 설계하는 문제다.
클라우드와 온프레미스도 정답은 하나가 아니다
클라우드는 필요한 자원을 탄력적으로 확보하고 여러 지역의 연구자가 협업하기에 유리하다. 반면 대규모 데이터를 반복적으로 이동하고 장기간 저장하면 비용이 누적될 수 있다. 환자 유래 데이터의 보안과 데이터 주권도 고려해야 한다.
온프레미스 환경은 데이터 통제와 반복적인 대규모 분석에서 장점이 있지만, 초기 투자와 운영 인력이 필요하며 최대 수요에 맞춘 장비가 평상시에는 유휴 상태가 될 수 있다. 작은 cohort나 일회성 프로젝트에서는 기존 서버 또는 클라우드 인스턴스가 오히려 더 경제적이다.
중요한 것은 특정 방식을 고집하는 것이 아니라 분석 빈도, 데이터 이동량, 보안 요구와 처리 시간을 기준으로 총비용을 비교하는 것이다.
Portrai가 확인한 보이지 않는 비용
Portrai가 수행한 특정 CPU 전처리 PoC에서는 약 3,478만 개의 세포와 약 291억 개의 non-zero expression entries를 처리할 때 peak memory가 약 2.18 TiB까지 증가했다. 이는 모든 공간전사체 분석에 동일하게 적용되는 수치가 아니라, 해당 데이터 구조와 filter_empty 워크로드에서 관찰된 결과다.
이 경험에서 중요했던 것은 데이터 크기 자체보다 특정 전처리 단계가 전체 시스템의 메모리 사양을 결정했다는 점이다. 분석 코드를 일부 최적화하는 것만으로 충분한 경우도 있지만, 데이터가 반복적으로 이 규모를 넘어선다면 소프트웨어 개선과 함께 메모리 계층 구조를 다시 설계해야 한다.
하나의 고가 서버보다 계층화된 구조
단기적으로는 데이터를 sparse·chunked 형태로 유지하고, 필요한 부분만 읽는 out-of-core computing과 caching을 적용해야 한다. 불필요한 복사와 형식 변환을 줄이는 것만으로도 비용을 크게 낮출 수 있다.
중기적으로는 빠른 DRAM과 상대적으로 저렴한 enterprise SSD를 계층화하여 모든 데이터를 고가 메모리에 상주시킬 필요가 없는 구조를 검토할 수 있다. 데이터 생성 단계부터 이후의 필터링·통합·시각화 방식을 고려한 공동 설계도 필요하다.
장기적으로는 CXL을 활용한 메모리 확장, 데이터 이동을 분담하는 DPU, 특정 연산에 적합한 NPU 등이 대안이 될 수 있다. 다만 이 기술들이 실제 공간전사체 workload에서 성능과 비용을 모두 개선하는지는 benchmark를 통해 검증해야 한다. 새로운 하드웨어가 소프트웨어 복잡성과 운영비를 더할 가능성도 있다. 하지만 현재의 일반적인 서버 구성에서는 특정 task를 위해 과도한 서버 인프라가 필요하며, 이는 당분간 가장 중요한 병목으로 자리 잡을 것으로 생각된다.
앞으로 5년
낙관적으로는 공간생물학에 최적화된 데이터 형식과 메모리 계층, 가속기가 함께 발전해 수천만 세포 분석이 일반적인 workflow가 될 수 있다. 현실적으로는 workload별로 클라우드와 온프레미스, 범용 장비와 차세대 인프라를 혼합하는 구조가 확산될 가능성이 높다.
반대로 처리량 경쟁만 지속되고 분석당 총비용이 낮아지지 않는다면, 데이터를 생성할 수 있는 기관과 실제로 활용할 수 있는 기관 사이의 격차가 더 커질 수 있다. 그리고 그 현상은 지금도 일어나고 있다. 비싼 공간 전사체 장비를 사고 데이터를 생산하고도 논문으로, 세상을 더 낫게 바꾸는 연구로 피어나지 못하는 데이터가 쌓여간다.
The next bottleneck in spatial biology may not be biology. It may be memory architecture.
그러나 대규모 데이터를 빠르게 처리하더라도, 사람이 그 결과 안에서 의미를 발견하는 것은 전혀 다른 문제다. 다음 글에서는 데이터 인프라 위에서 연구자가 코딩과 서버 관리의 부담을 넘어 실제 질문에 집중하게 만드는 분석 경험의 대중화를 살펴보려 한다.