분석의 대중화란 복잡성을 감추는 것이 아니라, 더 많은 사람이 그 복잡성을 검토할 수 있게 만드는 것이다.
공간전사체 실험이 끝나도 연구자의 일은 끝나지 않는다. 서버를 준비하고, 대용량 파일을 옮기고, 분석 패키지의 버전을 맞춰야 한다. 실행되지 않는 코드를 수정하고 메모리 부족을 해결한 뒤에야 조직을 분석해 낸 결과를 열어볼 수 있다.
문제는 여기서 끝나지 않는다. 병리 이미지 위의 위치, 수백만 개의 세포 유형, 수천 개의 유전자 발현 및 환자의 임상 정보를 동시에 해석해야 한다. 각각은 익숙한 데이터일 수 있지만, 이들을 한 화면과 하나의 사고 과정 안에서 연결하는 일은 어렵다.
공간전사체 분석의 병목은 코딩 자체보다 더 크다. 데이터를 신뢰할 수 있는 질문과 의사 결정으로 바꾸는 과정의 인지적 복잡성이다.
데이터를 처리하는 것과 탐색하는 것은 다르다
기존 분석 workflow는 정해진 질문에 답하는 데 강하다. 분석가가 코드를 작성하고 결과를 그림과 표로 전달하면 연구자는 이를 해석한다. 하지만 새로운 질문이 생길 때마다 분석을 다시 요청해야 한다.
공간 데이터에서는 질문이 시각적 탐색 중에 계속 달라진다. 특정 표적이 높은 세포를 발견하면 주변 면역세포를 보고 싶고, 다시 치료 이력이 다른 환자에서 같은 패턴이 반복되는지 확인하고 싶어진다. 분석가와 생물학자 사이의 반복 주기가 길수록 중요한 질문은 뒤로 밀린다.
따라서 한 장의 슬라이드를 빠르게 표시하는 것만으로는 충분하지 않다. 여러 환자와 슬라이드에서 같은 조건을 적용하고 결과를 비교할 수 있어야 한다. 환자별 관심 영역을 가상으로 모으는 in-silico TMA 또는 조건에 맞는 환자를 즉시 구성하는 virtual cohort가 필요한 이유다. (Cohortlab 링크)
자연어가 장벽을 낮추지만, 정답을 보장하지는 않는다
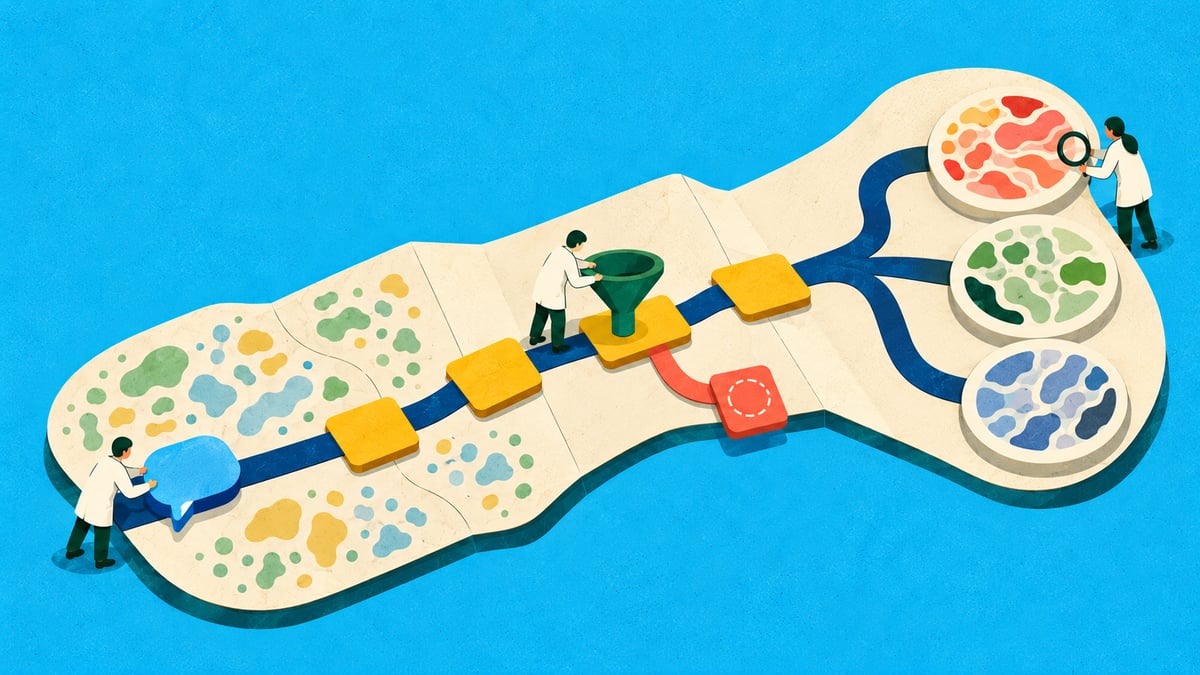
WebGPU와 같은 브라우저 기반 가속 기술은 별도의 고성능 소프트웨어를 설치하지 않고도 웹에서 대규모 공간 데이터를 손쉽게 시각적으로 탐색할 수 있게 한다. 자연어 agent는 “표적이 높고 T세포와 가까운 암세포를 보여 달라”는 질문을 필터와 분석 명령으로 전환할 수 있다.
그러나 사용하기 쉬운 interface가 분석을 자동으로 정확하게 만들지는 않는다. ‘높다’, ‘가깝다’, ‘충분하다’는 표현에는 기준값과 거리 정의가 필요하다. 자연어의 모호함이 숨겨진 채 결과만 그럴듯하게 제시되면 잘못된 분석을 이전보다 더 빠르게 만들 수 있다.
이것이 no-code가 곧 democratization을 의미하지 않는 이유다. 사용자는 자연어 질문이 어떤 데이터와 필터, 통계 방법으로 변환되었는지 확인하고 수정할 수 있어야 한다.
Democratization does not mean hiding complexity. It means making complexity inspectable.
탐색과 확증을 분리해야 한다
단기적으로는 탐색적 분석과 확증적 분석을 구분해야 한다. 시각적 탐색과 자연어 agent는 가설을 발견하는 데 유용하지만, 최종 결론은 사전에 정의된 기준과 통계 검증을 거쳐야 한다.
모든 분석에는 사용한 데이터, parameter, 소프트웨어 버전과 처리 순서를 기록하는 lineage가 남아야 한다. 동일한 질문을 다른 연구자가 다시 실행했을 때 같은 결과를 얻을 수 있어야 한다.
중기적으로는 analyst와 biologist가 같은 화면에서 결과를 검토하는 구조가 필요하다. 생물학자는 세포와 조직의 맥락을 설명하고, 분석가는 데이터 품질과 통계적 가정을 확인해야 한다. 좋은 UX는 두 전문가 중 한쪽을 제거하는 것이 아니라 서로의 판단을 연결한다.
장기적으로는 데이터의 민감도와 사용 목적에 따라 클라우드, private VPC 또는 on-premise 환경을 선택할 수 있어야 한다. 시각화가 빨라도 컴퓨팅 비용이 지나치게 높다면 반복적으로 사용되기 어렵기 때문에, UX와 인프라는 처음부터 함께 설계되어야 한다.
Portrai가 얻은 교훈
Portrai가 대규모 공간 데이터를 탐색하는 Explorer와 자연어 agent를 개발하면서 발견한 것은, 연구자가 원한 것이 반드시 더 많은 분석 기능은 아니었다는 점이다. 더 중요한 요구는 서버와 코드 관리에서 벗어나 생물학적 질문을 즉시 시험하고, 여러 환자에서 같은 현상을 비교하는 것이었다.
동시에 filter와 기준값을 보이지 않게 처리하면 편의성이 신뢰를 약화할 수 있다는 점도 확인했다. 자연어 질문은 명시적인 분석 단계로 변환되어야 하며, 사용자가 그 과정을 검토하고 재사용할 수 있어야 한다. Agent는 분석가를 대신하는 자동응답기가 아니라 연구자와 데이터 사이의 번역기여야 한다.
전문가용 코드 분석도 여전히 필요하다. 새로운 알고리즘 개발, 복잡한 통계 모델링, 규제 또는 임상적 판단에 사용될 결과는 정형화된 interface만으로 충분하지 않을 수 있다. 좋은 플랫폼은 코드를 없애기보다 반복 작업은 단순화하고, 전문 분석이 필요한 경계를 명확히 해야 한다.
앞으로 5년
낙관적으로는 연구자가 자연어로 가설을 제시하고, 여러 환자에서 즉시 검토한 뒤, 재현 가능한 분석으로 전환하는 환경이 보편화될 수 있다.
현실적으로는 표준화된 탐색과 비교 기능부터 확산되고, 고위험 의사 결정에는 전문가 검토가 유지될 가능성이 높다. 반대로 편리한 AI interface가 출처와 분석 과정을 감춘다면, 보기 좋은 결과와 잘못된 확신이 함께 증가할 수도 있다.
결국 분석을 쉽게 만드는 것과 분석을 믿을 수 있게 만드는 것은 동일한 일이 아니다. 다음 글에서는 공간전사체가 연구 도구를 넘어 산업의 표준 인프라가 되기 위한 마지막 조건인 신뢰, 재현성, 그리고 표준화를 살펴보려 한다.